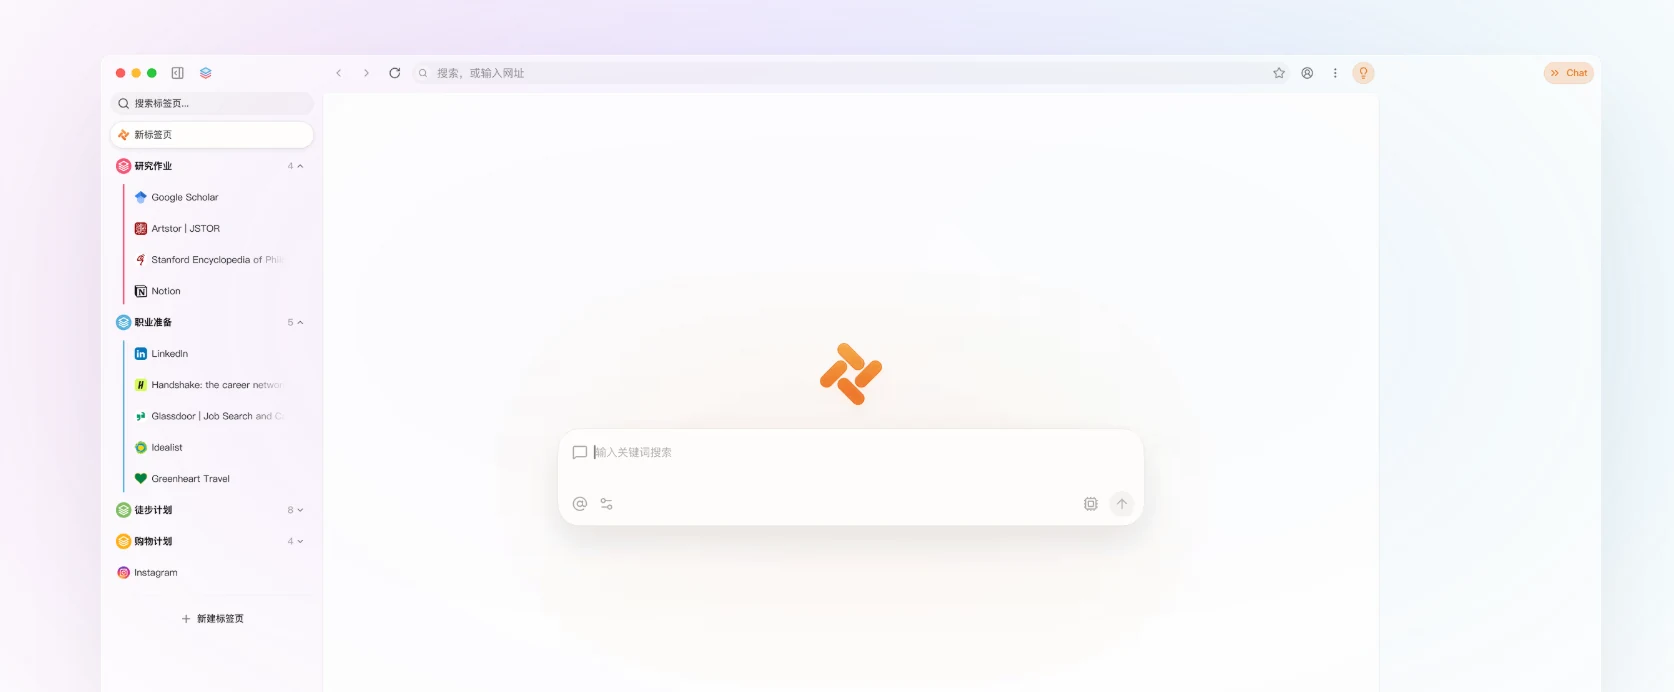
从打开网页,到完成一件事。
白领在检索、对比资料和多步办公任务中,经常需要在多个网页与文件间切换,再手动复制、整理和核对。Tabbit 希望把这些割裂的动作收敛到浏览器内,让用户用自然语言发起目标,由 Agent 理解材料并推进任务。
我的工作重点
我主要参与输入与记忆设计、Agent 执行循环和评测:梳理意图与字段规则,设计澄清和异常路径,与算法、研发对齐验收指标,再根据 Bad Case 推进迭代。
我如何与团队协作
我从产品侧对齐用户目标、执行规则、体验与验收口径;与算法和研发协作,将这些要求落到解析能力、接口和执行框架中。
先收敛边界,才能跑通闭环。
我参与收敛首版范围:保留地址栏、标签页、收藏等熟悉的浏览器能力,用统一输入框承接访问、搜索、材料理解和复杂任务。关键是让入口简单,同时给后台链路明确的分流与停止条件。
首版重点支持
自然语言统一入口;当前网页、选中文本与指定标签页引用;多网页理解与对比;复杂任务拆解、执行、校验和结果交付。
首版暂不扩展
全场景自主操作、本地生活交易闭环、MCP 外部工具市场和系统级桌面控制。高风险外部动作保留用户确认点。
先理解目标,再选择正确的材料。
四类意图,匹配不同处理成本
我参与收敛过细的输入路由,让访问和轻量问答走短链路;需要多步推进、工具调用和反复验证的任务,才进入执行循环。这样既控制处理成本,也让异常更容易定位。
| 意图 | 典型请求(示例) | 产品处理重点 |
|---|---|---|
| 访问网页 | 打开指定网站 | 识别目标域名,保证准确与快速。 |
| 搜索信息 | 找一份行业报告 | 检索多来源信息,识别相关性与时效。 |
| 理解材料 / 问答 | 总结这个网页 | 明确引用对象,基于材料完成理解。 |
| 复杂任务 | 比较多份资料并整理成表格 | 补齐目标与约束,进入任务规划和执行。 |
把模糊表达转成可执行字段
我参与梳理输入链路的必填与可选字段,包括任务对象、材料范围、输出格式、时间要求和风险信息。关键字段缺失时,先检查已有上下文和记忆,仍无法补齐才向用户澄清;对混合意图则拆分子任务,明确先后依赖。
上下文选择与冲突处理
材料范围由任务决定
优先使用选中文本、当前页和用户明确指定的标签页;上传文件作为主动提供的材料。不会因为浏览器能够访问,就默认读取全部历史与后台页面。
保留信息来源与关键字段
解析材料时保留正文、来源、日期和任务必需字段。长材料按任务提取相关片段,需要全局理解时再使用临时材料索引。
当前确认优先于历史偏好
区分当前明确表达、短期任务状态与长期偏好。发生冲突时优先采用用户当前确认的信息,仍有歧义则澄清。
记忆服务于任务连续性
任务内记忆复用已完成结果,项目记忆支持跨轮次推进,偏好记忆辅助表达方式。避免反复读取、重复提取与无效重做。
让每一次执行,都有下一步和终点。
我参与设计从任务解析到重新规划的执行 Loop,并把每一步的关键字段和阶段目标纳入校验。输入明确后先拆解依赖,再调用工具;执行后根据校验结果决定继续、重试、换路或停止。
| 节点 | 需要明确的规则 | 面向用户的价值 |
|---|---|---|
| 任务解析 | 目标、材料、约束和交付格式结构化 | 减少任务理解偏差。 |
| 规划执行 | 确定步骤依赖与工具输入输出 | 复杂任务能够按顺序推进。 |
| 结果校验 | 检查必填字段、返回状态与来源 | 避免“看起来完成,实际缺项”。 |
| 重新规划 | 临时失败原节点重试;路径无效则换源或换路 | 保留已完成结果,减少从头重做。 |
| 结束与兜底 | 达到目标结束;达到上限或持续缺失则解释失败 | 避免无限等待和强行生成。 |
工具失败,也需要有产品体验
区分失败来自哪里
分别记录未触发调用、接口调用失败、返回内容缺失与所选工具不合适。不同类型需要不同修复方式,不能统一归因为“模型不好”。
确定性规则优先校验
必填字段是否存在、返回是否成功等问题可用规则检查;语义理解和方案判断由模型承担。工具输出还需核对来源和时效。
把“答案不对”,拆成可以修复的问题。
我参与搭建 600 条、6 个任务层级的内测集,以及 120 条对抗样本。普通样本用于检验高频任务的可用性,对抗样本集中暴露意图歧义、上下文冲突、材料或字段缺失、工具失败及高风险动作。
| 测评层级 | 观察什么 | 对应迭代动作 |
|---|---|---|
| 意图与规划 | 分类是否准确,步骤是否完整 | 调整分类、字段要求和提示词。 |
| 上下文 | 是否引用正确材料,关键信息有无遗漏 | 调整材料优先级、解析与结构化规则。 |
| 执行与工具 | 是否在正确节点调用,失败能否回退 | 优化触发条件、重试路径和兜底。 |
| 最终结果 | 任务完成、格式满足与来源可追溯 | 修订验收口径,补充新样本。 |
让评测形成可追踪的迭代闭环
我结合分模块离线测评、多模型交叉判断和人工复核定位 Bad Case,把问题反馈到提示词、字段规则或工具调用链路,再通过相关样本回归检查修改是否有效。上线后,我结合后端日志、前端埋点和采纳行为,继续观察任务是否真正被用户使用。
场景复盘:多网页任务中的字段缺失与工具失败
在多网页对比和资料整理任务中,我重点关注“链路继续运行,但关键字段没有拿到”这类问题。我的处理重点是把失败拆到节点,再对齐校验与兜底规则。
1 / 定位:缺在输入,还是缺在执行?
我结合节点输出与人工复核,区分意图歧义、上下文冲突、必填字段缺失和工具失败;工具问题再拆成未触发、接口失败、返回不全或工具选错,避免所有问题都落到同一个提示词上。
2 / 调整:补齐字段,再决定能否继续
我参与定义必填与可选字段:先检查上下文和记忆,信息不足再澄清。执行后校验关键字段与阶段目标;工具失败按情况重试、换源或降级,同时设置循环上限与失败解释,避免缺项时仍宣称完成。
3 / 验证:回到对应类别的样本
我把这些问题纳入分模块离线测评,结合多模型判断与人工复核推进回归。验证重点是字段是否补齐、来源是否可追溯、失败是否按预期结束,再看完整任务能否通过验收。
任务能完成,结果也要被采用。
Agent 任务完成率
+37.7 个百分点
结果采纳率
+30.7 个百分点
我用任务完成率观察核心链路是否可用,再用结果采纳率观察输出能否被用户接受;定位问题时,则继续下钻到意图、上下文与执行节点。
沿链路定位改善发生在哪里
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 意图识别准确率 | 78.4% | 94.6% | +16.2 个百分点 |
| 上下文命中率 | 64.5% | 91.8% | +27.3 个百分点 |
| Loop 完成率 | 46.3% | 87.6% | +41.3 个百分点 |
| 单步工具成功率 | 58.7% | 89.4% | +30.7 个百分点 |
| 幻觉率(越低越好) | 13.8% | 3.7% | 下降 10.1 个百分点 |
| 任务模式使用占比 | 19.4% | 36.8% | +17.4 个百分点 |
观察后续使用
Agent 任务用户的 7 日留存为 32.7%,轻量问答用户为 18.5%。这让我继续关注网页总结、竞品对比和学习资料整理等高频任务的稳定性与复用体验。
可靠性,是 AI 体验的一部分。
产品设计要覆盖失败路径
输入、工具和材料都可能不完整。澄清、停止、失败解释和部分结果交付,决定了用户是否理解系统、是否愿意继续使用。
验收指标需要沿链路拆解
整体完成率说明“有没有完成”,节点指标说明“为什么没完成”。两者一起看,才能确定下一轮迭代优先级。
后续探索:把高频流程沉淀为“妙招”
我从场景分布中识别出网页总结、竞品对比与学习资料整理等高频需求。下一步,我希望先提升这些任务的稳定性,再把反复验证的步骤沉淀为可调整的 Skill:保留任务目标、输入要求、材料范围、工具、步骤和输出格式,避免绑定某一次任务的具体页面。